Edukasi DePIN: Inferensi AI Terdesentralisasi, Sewa GPU Tanpa Cloud Raksasa
Edukasi DePIN: inferensi AI terdesentralisasi — pasar terbuka tempat pemilik GPU menyewakan kapasitas menganggurnya untuk menjalankan model AI, lengkap dengan cara kerja, kritik, dan hipotesis redaksi.
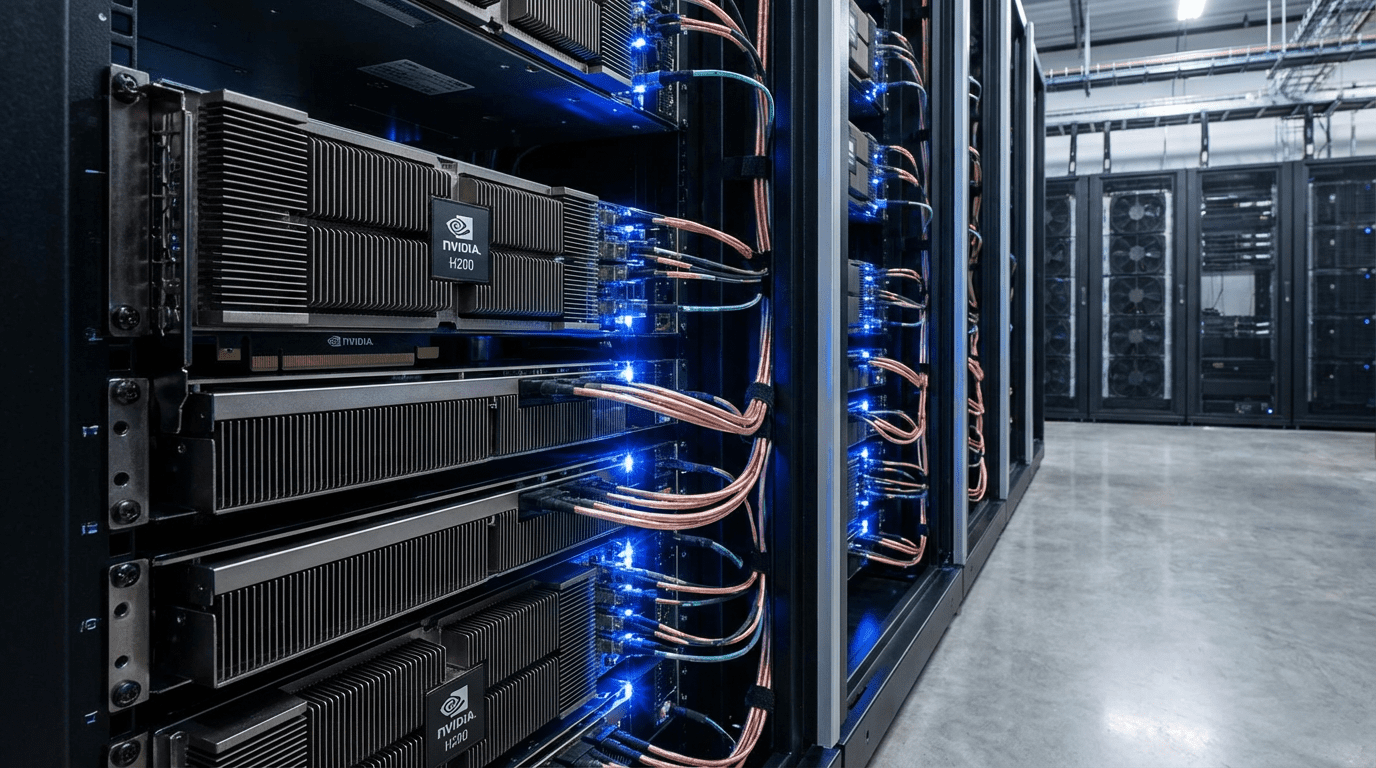
Setelah membahas komputasi, penyimpanan, nirkabel, sensor, energi, hingga privasi, seri edukasi DePIN kali ini masuk ke lapisan yang paling dekat dengan ledakan AI: inferensi — yaitu proses menjalankan model AI yang sudah dilatih untuk menjawab pertanyaan pengguna.
Untuk memahami nilainya, bedakan dua fase kehidupan model AI. Pelatihan (training) adalah fase mahal yang dilakukan sekali oleh laboratorium besar. Inferensi adalah fase berulang yang terjadi setiap kali seseorang memakai AI: jutaan kali sehari, selamanya. Setiap chatbot, agen, dan fitur AI di aplikasi adalah inferensi. Dan setiap inferensi butuh GPU yang menyala.
Masalahnya: GPU itu mahal dan sering menganggur. Cloud raksasa menjualnya dengan harga premium, sementara ribuan GPU milik komunitas, perusahaan kecil, dan penambang kripto menganggur di sela waktu. DePIN inferensi menutup celah ini dengan pasar terbuka: pemilik GPU menawarkan kapasitas komputasinya, pengguna membayar per pemakaian, dan jaringan mencocokkan keduanya tanpa perantara terpusat.
Cara kerjanya bisa dipahami dalam tiga lapisan. Pertama, lapisan pasok: operator memasang perangkat lunak node dan mendaftarkan GPU-nya beserta spesifikasinya. Kedua, lapisan verifikasi: karena tidak ada yang mengawasi operator secara langsung, jaringan memakai mekanisme pembuktian — tantangan kriptografi acak, lingkungan eksekusi tepercaya (TEE), atau pengulangan sampling oleh node lain — untuk memastikan hasil komputasi benar dan bukan asal-asalan. Ketiga, lapisan pasar: harga terbentuk lewat lelang atau harga spot, mirip pasar listrik, di mana pengguna memilih kombinasi harga, kecepatan, dan lokasi.
Contoh polanya sudah berjalan. Pasar komputasi umum seperti Akash mempertemukan penyewa dan pemilik server dalam lelang terbuka, dan baru-baru ini memperbarui tokenomics-nya agar pembakaran token terkait langsung dengan pemakaian jaringan — bukan sekadar spekulasi. Di sisi lain ada jaringan yang fokus pada beban kerja AI spesifik, dari rendering hingga serving model bahasa.
Kritiknya juga nyata dan harus jujur disampaikan. Pertama, latensi dan lokasi: untuk aplikasi real-time, GPU di seberang benua kalah dari data center di kota yang sama. Kedua, verifikasi output: bagaimana pengguna yakin jawaban model tidak dimanipulasi operator nakal? Ini masalah riset yang belum tuntas. Ketiga, ekonomi perangkat: GPU terdepresiasi cepat — studi industri menyebut sekitar 17,9 persen per tahun — sehingga operator harus menghitung payback dengan jujur, bukan dengan janji imbal hasil. Keempat, kualitas layanan bervariasi: tidak semua node punya keandalan setara cloud terpusat.
Hipotesis redaksi: inferensi AI akan menjadi komoditas seperti listrik — pengguna tidak peduli dari pembangkit mana arusnya berasal, selama voltasenya stabil. Nilai jangka panjang bukan pada GPU-nya, melainkan pada lapisan verifikasi dan routing: siapa yang bisa menjamin hasil benar, cepat, dan murah dalam satu paket, dialah yang memenangkan pasar. Bagi Indonesia, peluangnya ada pada beban kerja yang toleran terhadap latensi — rendering, embedding, batch inference — dijalankan di atas GPU komunitas dan warnet yang hari ini menganggur di malam hari. Token hanyalah pelumasnya; yang dijual adalah komputasi yang benar-benar dipakai.
Sumber: Redaksi X AWD